Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
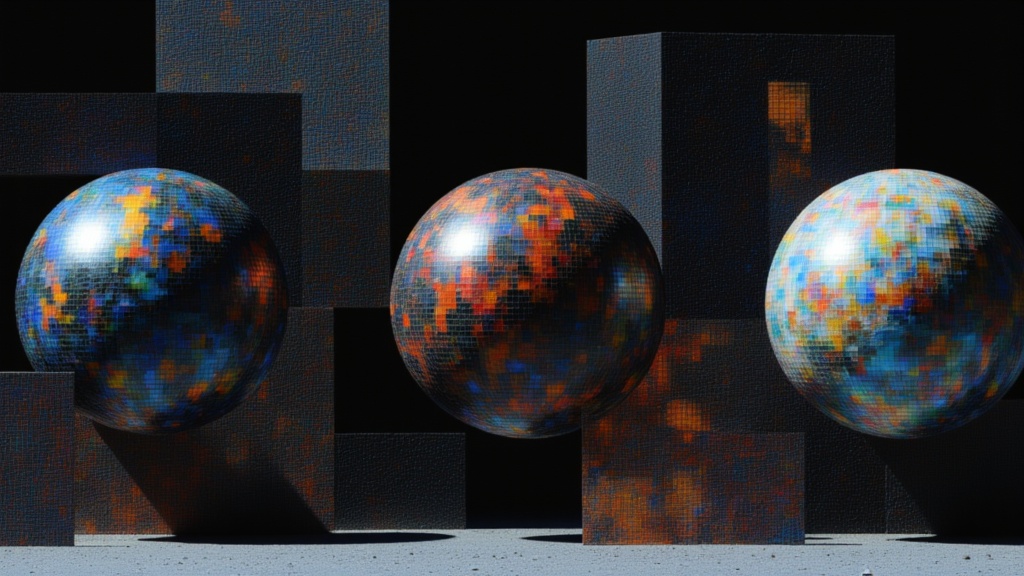
Генерация полных бесшовно тайлящихся PBR-материалов с картами normal, roughness, basecolor, height и metalness до 8K.
Модель MOSS-Image-SFT для генерации изображений по тексту. Специализируется на отрисовке текста на китайском и английском языках и управлении структурой композиции: точное размещение надписей и объектов.
Запуск любой модели Stable Diffusion с настраиваемыми весами LoRA.
Создаёт иллюзии на основе изображения.
Модель Phota для разработчиков, фотографов и авторов: персонализированная генерация и редактирование фотографий.
Генерация изображений по тексту на основе Boogu-Image.
Nucleus-Image — модель генерации изображений по тексту на основе диффузионного трансформера с разреженной архитектурой MoE (mixture of experts).
Модель с открытым исходным кодом, лучшая в своём классе по эстетическому качеству (SOTA)
Генерация реалистичных изображений.
Параметры по умолчанию с автоматической оптимизацией и улучшением качества.
AuraFlow v0.3 — flow-модель генерации изображений по тексту с открытым исходным кодом, показавшая SOTA-результаты на GenEval. Сейчас находится в стадии беты.
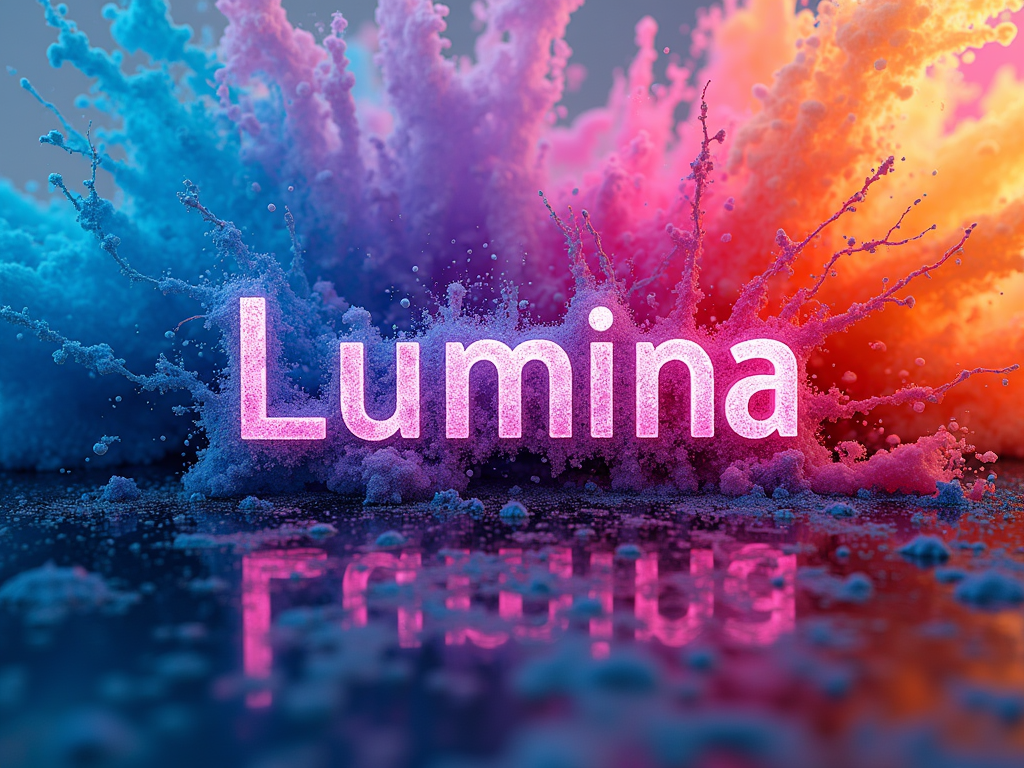
Lumina-Image-2.0 — диффузионный трансформер на основе потоков (flow-based) с 2 миллиардами параметров. Улучшены качество изображений, работа с типографикой, понимание сложных промптов и ресурсоэффективность.
Дообученная модель Pony V7 для генерации изображений по тексту: отличная эстетика и точное следование промпту.
Параметры по умолчанию с автоматической оптимизацией и улучшением качества.
Универсальная модель генерации изображений, которая создаёт самые разные картинки по мультимодальным запросам. Подходит для редактирования изображений, персонализированной генерации, виртуальной примерки, генерации сцен с несколькими людьми и других задач.
Генерация изображений с BitDance. Быстро создаёт фотореалистичные изображения высокого разрешения с помощью авторегрессионной LLM — эффективно и с высоким качеством.
Модель Dreamshaper.
OmniGen — универсальная модель генерации изображений, которая создаёт самые разные изображения по мультимодальным промптам. Подходит для редактирования изображений, персонализированной генерации, виртуальной примерки, генерации сцен с несколькими людьми и других задач.
Bagel — мультимодальная модель на 7B параметров от Bytedance-Seed, которая умеет генерировать и текст, и изображения.
Генерация инфографики с помощью Sensenova U1.
Ovis-Image — модель на 7B параметров для генерации изображений по тексту, оптимизированная для быстрой и качественной отрисовки текста.
DeepSeek Janus-Pro — новая модель для генерации изображений по тексту, которая объединяет мультимодальное понимание и генерацию в рамках авторегрессионного подхода
Генерация изображений по тексту с помощью Emu 3.5 Image
Параметры по умолчанию с автоматической оптимизацией и улучшением качества.
SDXL со сверхбыстрой генерацией.
Генерация векторных шрифтов с VecGlypher. Создаёт собственные глифы по текстовому описанию или референсным изображениям и сразу выдаёт чистые SVG-контуры без преобразования растра в вектор.
Параметры по умолчанию с автоматической оптимизацией и улучшением качества.