Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
Fibo 2.0 Edit вносит точечные правки по инструкциям, используя до четырёх изображений. Замена фона, новая постановка товара с сохранением его точного вида. Обучена только на лицензированных данных, коммерческие права чётко определены.
Генерация детализированных изображений по тексту в Krea 2 с кастомной LoRA. Веса вашей LoRA переносят выученный объект, персонажа или стиль в новые генерации. Доступны настройки соотношения сторон, креативности и seed.
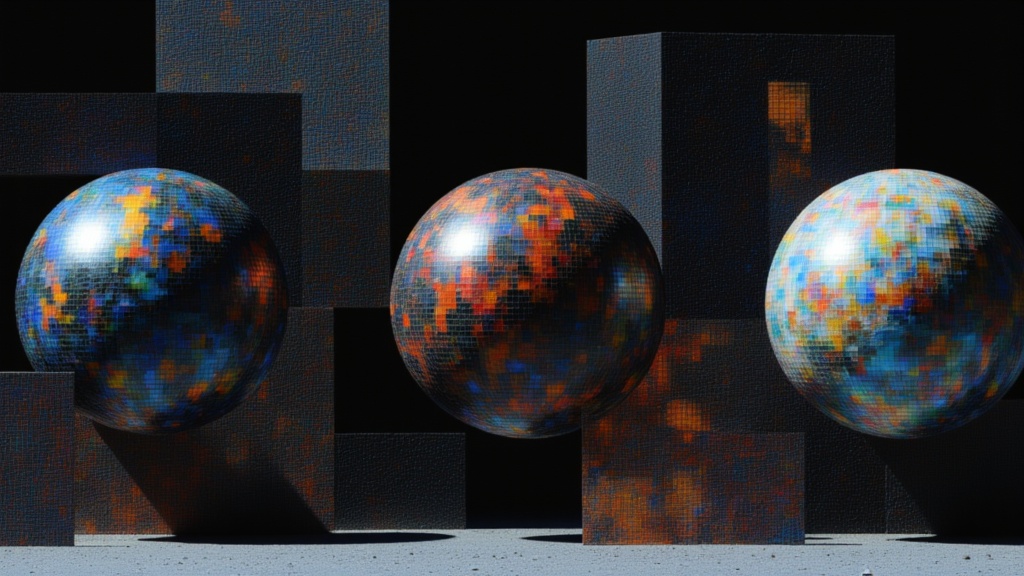
Генерация полных бесшовно тайлящихся PBR-материалов с картами normal, roughness, basecolor, height и metalness до 8K.
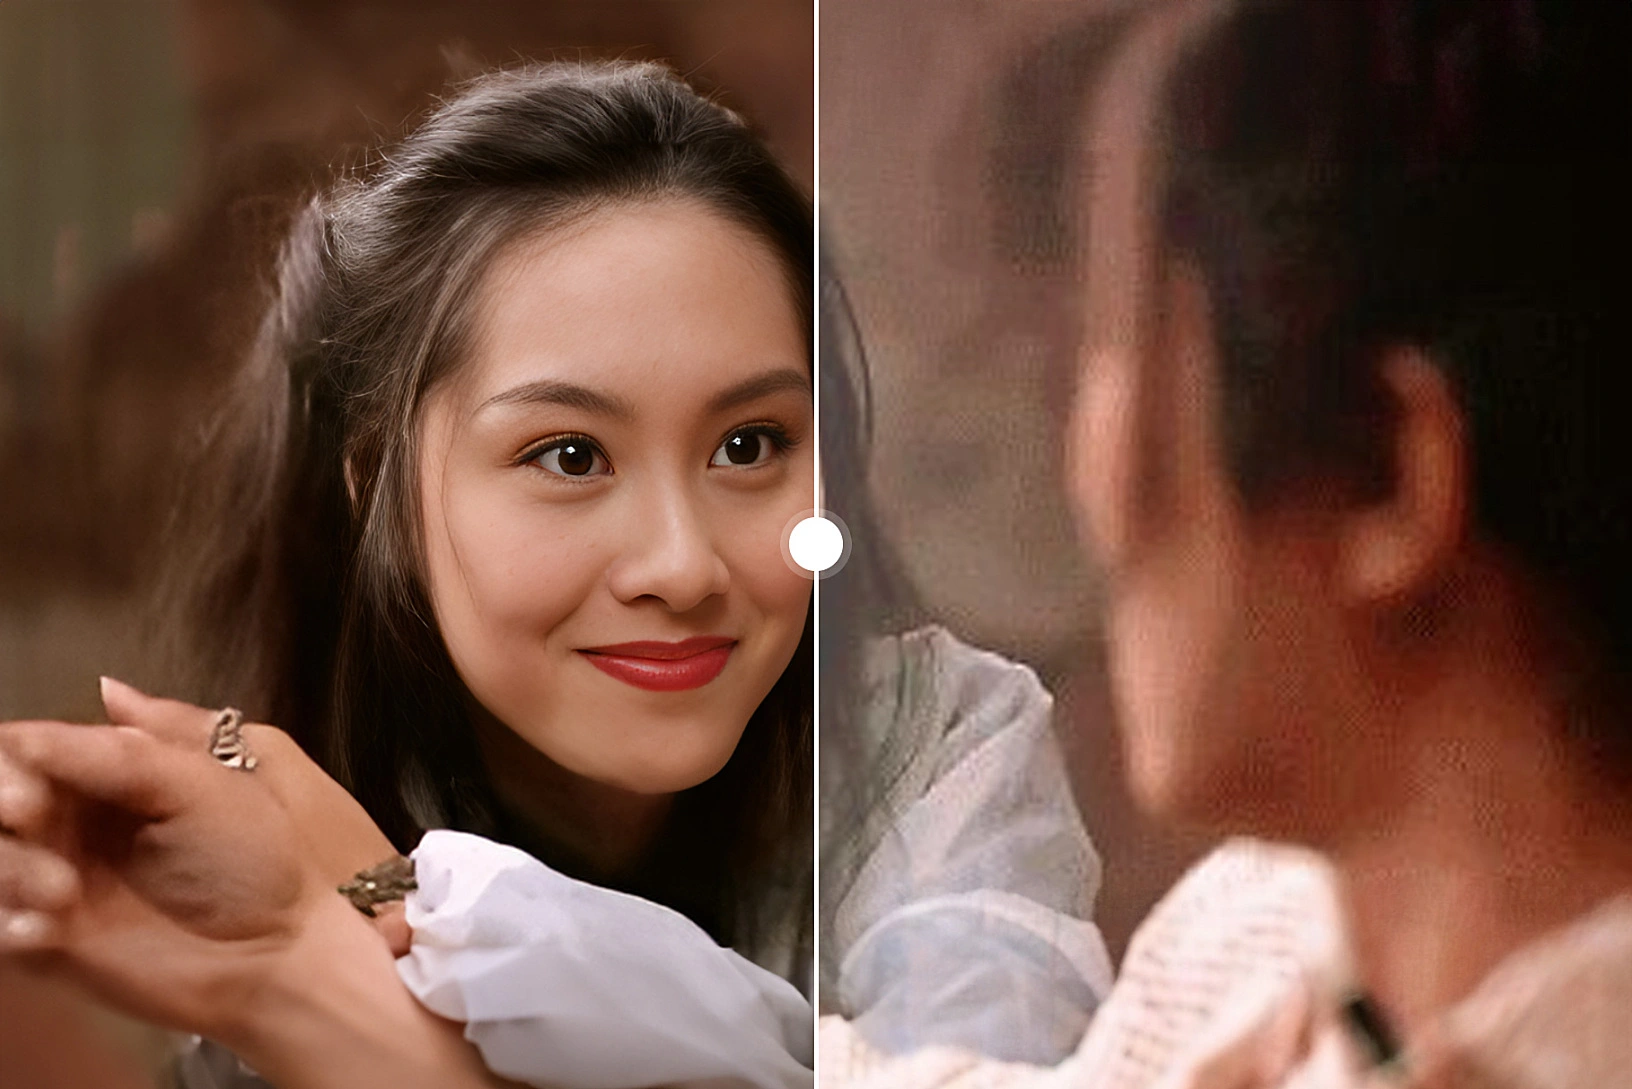
Исправление искажённых и размытых фотографий людей с помощью CodeFormer.
Модель MOSS-Image-SFT для генерации изображений по тексту. Специализируется на отрисовке текста на китайском и английском языках и управлении структурой композиции: точное размещение надписей и объектов.
Увеличение разрешения любого изображения в 2 или 4 раза, до 8192×8192, с помощью Bria Increase Resolution. Исходное содержимое сохраняется: без перегенерации и изменения деталей. Безопасно для коммерческого использования.
Bria Expand расширяет изображение за его границы до любого из 9 соотношений сторон или до произвольного холста размером до 25 мегапикселей. Построена на FIBO-Edit-1.5; для новой области можно задать промпт, а исходные пиксели остаются в полном разрешении.
Fibo 2.0 Generate — модель Bria для генерации изображений по тексту. Лучше всего справляется с промптами, требующими рассуждений и знаний, то есть настоящего понимания, а не просто подбора стиля. Обучена только на лицензированных данных, коммерческие права чётко определены.
Florence-2 — продвинутая базовая модель компьютерного зрения. Использует подход на основе промптов и решает широкий круг задач зрения и задач на стыке зрения и языка
Профессиональное креативное увеличение разрешения изображений на базе Topaz Labs. Bloom 2 заново придумывает детали, позволяет настраивать степень креативности и сохраняет цвета. Лучше всего подходит для изображений, сгенерированных ИИ, которым нужно заметное улучшение.
Направленное расширение изображения (outpainting). Выберите, с каких сторон расширять: слева, справа, сверху или по центру (равномерно со всех сторон). Генерируются только добавленные области; дополнительно можно отдалить кадр на заданную величину.
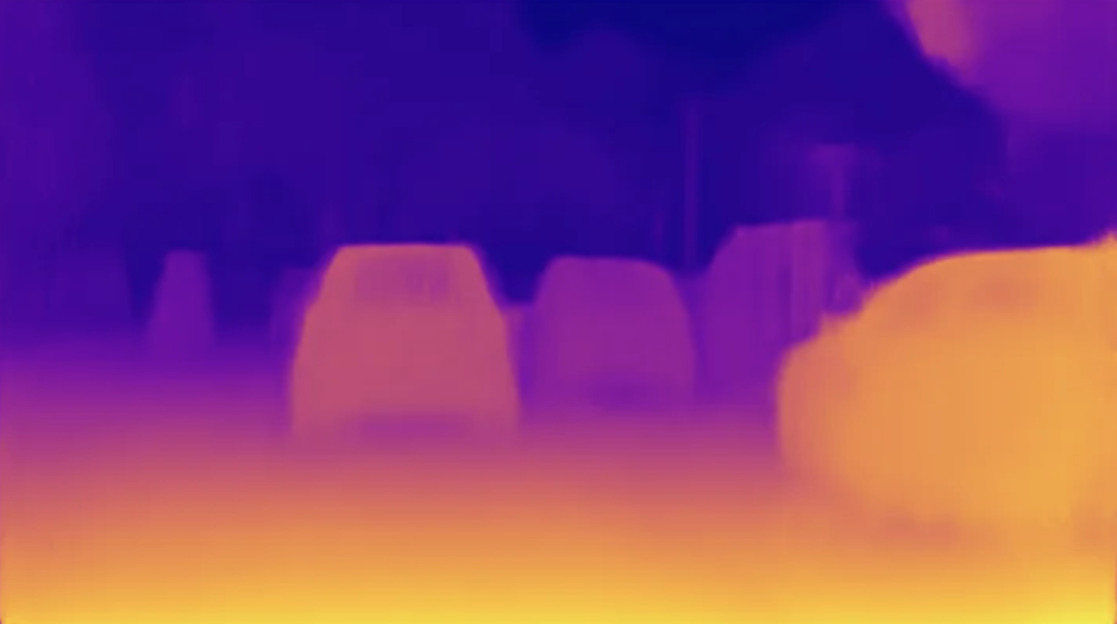
Построение карт глубины с помощью оценки глубины Midas.
Увеличение разрешения изображений с помощью SeedVR2 с сохранением бесшовного тайлинга.
Удаление фона по текстовому запросу. Берёт за основу такой же чистый вырез, как Bria RMBG, а затем по простым словам вроде «человек с ковриком и растением» или «только стул» добавляет объекты, убирает их или оставляет только нужные. Исходные пиксели, настоящий альфа-канал, ничего не перерисовывается.
Утилита FFMPEG для извлечения n-го кадра.
Генерация качественных изображений по тексту с помощью Krea 2 Medium. Поддерживает настройку соотношения сторон и степени креативности, сиды и необязательные стилевые референсы.
PATINA создаёт по изображениям бесшовные карты нормалей, шероховатости, базового цвета (albedo), высот (displacement) и металличности в высоком разрешении
Помещает любой продукт в любое окружение по текстовому запросу или референсному изображению, сохраняя точность передачи товара. Обучена исключительно на лицензированных данных, поэтому безопасна для коммерческого использования, и оптимизирована для eCommerce.
Bria Background Replace позволяет быстро заменять фон на изображениях по текстовому промпту или референсу и даёт реалистичный, аккуратный результат. Обучена только на лицензированных данных, поэтому безопасна для коммерческого использования без рисков.
Эндпоинт редактирования изображений для Hunyuan Image 3.0 Instruct.
Finegrain Eraser удаляет любой объект, выделенный маской, вместе с его тенями, отражениями и артефактами освещения, бесшовно восстанавливая сцену с учётом контекста.
Модель Microsoft для фотореалистичной генерации и редактирования изображений: превращает текстовые запросы или загруженные картинки в качественные визуалы для дизайна с детальным попиксельным контролем.
Florence-2 — продвинутая базовая модель компьютерного зрения. С помощью промптов решает широкий круг задач как в области зрения, так и на стыке зрения и языка.
Удаляет объекты, выделенные маской, вместе с их визуальными эффектами и бесшовно восстанавливает сцену подходящим по контексту содержимым.
Восстановление и улучшение старых или поврежденных фотографий: убирает дефекты и добавляет цвет, сохраняя характер и детали исходного снимка.

Создание карт глубины с помощью оценки глубины Marigold.
FeyNobg — SOTA-модель от feyninc для удаления фона.
Модель Microsoft для фотореалистичной генерации и редактирования изображений: превращает текстовые запросы или загруженные изображения в качественные визуалы, готовые для дизайна, с детальным управлением на уровне пикселей.
Передовые возможности Hunyuan Image 3.0 для создания визуального контента, который точно передаёт смысл вашего текста.
Виртуальная примерка одежды: модель объединяет изображения человека и одежды.
Профессиональное увеличение разрешения изображений с прозрачностью на базе Topaz Labs. Альфа-канал сохраняется на всём пути, результат выдаётся в PNG. Лучше всего подходит для логотипов, стикеров и других материалов с прозрачным фоном.
Florence-2 — продвинутая базовая модель компьютерного зрения, которая работает по текстовым подсказкам и решает широкий круг задач как визуальных, так и на стыке зрения и языка.
Раскрашивает старые и новые чёрно-белые фотографии с помощью DDColor.
Florence-2 — продвинутая базовая модель компьютерного зрения, которая через запросы решает широкий круг задач на стыке зрения и языка.
Sana синтезирует качественные изображения высокого разрешения с хорошим соответствием тексту и делает это очень быстро: изображение 4K создаётся менее чем за секунду.
Bria Virtual Try-On редактирует фото человека так, что он оказывается в одежде или аксессуарах с одного–трёх референсных изображений; дополнительно можно задать текстовые инструкции. Построена на FIBO-Edit-1.5, поддерживает смену нескольких предметов одежды и по умолчанию сохраняет соотношение сторон исходного изображения.