Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
Препроцессор ZoeDepth.
Bria Product Holding редактирует фото человека так, чтобы он держал или нёс продукт. Использует от одного до трёх референсных изображений продукта и необязательные текстовые инструкции. Построена на FIBO-Edit-1.5, по умолчанию сохраняет исходное соотношение сторон и позволяет выбрать соотношение сторон результата.
ControlLight — LoRA-дообучение FLUX.2 [klein] 9B, которое улучшает снимки при слабом освещении, сохраняя структуру сцены и мелкие детали. Единственный параметр alpha плавно регулирует силу эффекта: от лёгкого осветления до полного.
Создание профессиональных предметных фотографий с реалистичным освещением и фонами.
Finegrain Eraser удаляет объекты вместе с их тенями, отражениями и световыми артефактами по описанию на естественном языке, органично заполняя сцену подходящим по контексту содержимым.
Препроцессор TEED (Temporal Edge Enhancement Detection).
Смена стиля изображения с помощью TeleStyle v2: загрузите исходное изображение и референс стиля, и модель перерисует оригинал в визуальном стиле референса, сохранив содержание и композицию.
Создание качественных изображений с точной передачей текста и богатой детализацией. Поддерживает редактирование, перенос стиля и сохранение внешности персонажей на нескольких изображениях.
Улучшение и доработка портретных фото: больше чёткости и деталей.
Универсальная модель JoyAI-Image для работы с изображениями. Понимает, создаёт и редактирует изображения по описанию на естественном языке: глубокое визуальное понимание обеспечивает более точную генерацию и редактирование в единой системе.
Быстрая модель генерации изображений по тексту с низкой задержкой, высоким качеством и полным управлением через структурированный JSON. С открытым исходным кодом, обучена на лицензированных данных, оптимизирована для генерации в промышленных масштабах.
Профессиональная цветокоррекция фото: сбалансированные тона, яркие, но естественные цвета
Встраивайте товары в любую сцену с точным попиксельным контролем, автоматической перспективой и естественным освещением. Модель обучена на лицензированных данных, поэтому её безопасно использовать в рекламе и eCommerce.
Дообученная модель Pony V7 для генерации изображений по тексту: отличная эстетика и точное следование промпту.
Препроцессор оценки глубины MiDaS.
Единая мультимодальная модель DreamOmni2 для редактирования изображений по тексту и изображениям.
Параметры по умолчанию с автоматической оптимизацией и улучшением качества.
Модель Bria для генерации изображений по тексту, обученная исключительно на лицензированных данных, что делает её безопасной для коммерческого использования. Также доступна в виде исходного кода и весов. Чтобы получить доступ к весам: https://bria.ai/contact-us
Модель редактирования изображений от NVIDIA с логической согласованностью и учётом физики
Генерация превью для YouTube с произвольным текстом
Дорисовка фрагментов изображений с помощью SD и SDXL
Создание реалистичных фотографий людей по заданному образу с помощью Stacked ID Embedding
Превращайте обычные фотографии в волшебные работы в стиле Studio Ghibli
Редактирование изображений по изображению с помощью Step1X-Edit v2 от StepFun. Правки с рассуждениями в цикле «мышление — редактирование — рефлексия» и знаниями MLLM о мире для понимания абстрактных инструкций.
Цветокоррекция: настройка цветовой температуры, яркости, контраста, насыщенности и гаммы.
Универсальная модель генерации изображений, которая создаёт самые разные картинки по мультимодальным запросам. Подходит для редактирования изображений, персонализированной генерации, виртуальной примерки, генерации сцен с несколькими людьми и других задач.
Фотореалистичная генерация изображений по изображению
Превращайте фотографии в забавные плюшевые игрушки, сохраняя узнаваемость исходных персонажей.
Sana v1.5 1.6B — лёгкая модель для генерации изображений по тексту, которая эффективно создаёт изображения в разрешении 4K.
Мультимодальная модель на 7B параметров от Bytedance-Seed, умеющая генерировать и изображения, и текст.
Позволяет легко менять ракурс любого изображения.
Мощная модель для генерации изображений по тексту: создаёт 4K-изображения сверхвысокого качества с отличной детализацией. Sana v1.5, 4.8B.
Создаёт качественные изображения по тексту с помощью CogView4. Чем длиннее текстовый запрос, тем лучше результат.
Увеличивает разрешение изображения и очищает его от шумов и артефактов.
Запускает любую модель Stable Diffusion с настраиваемыми весами LoRA.
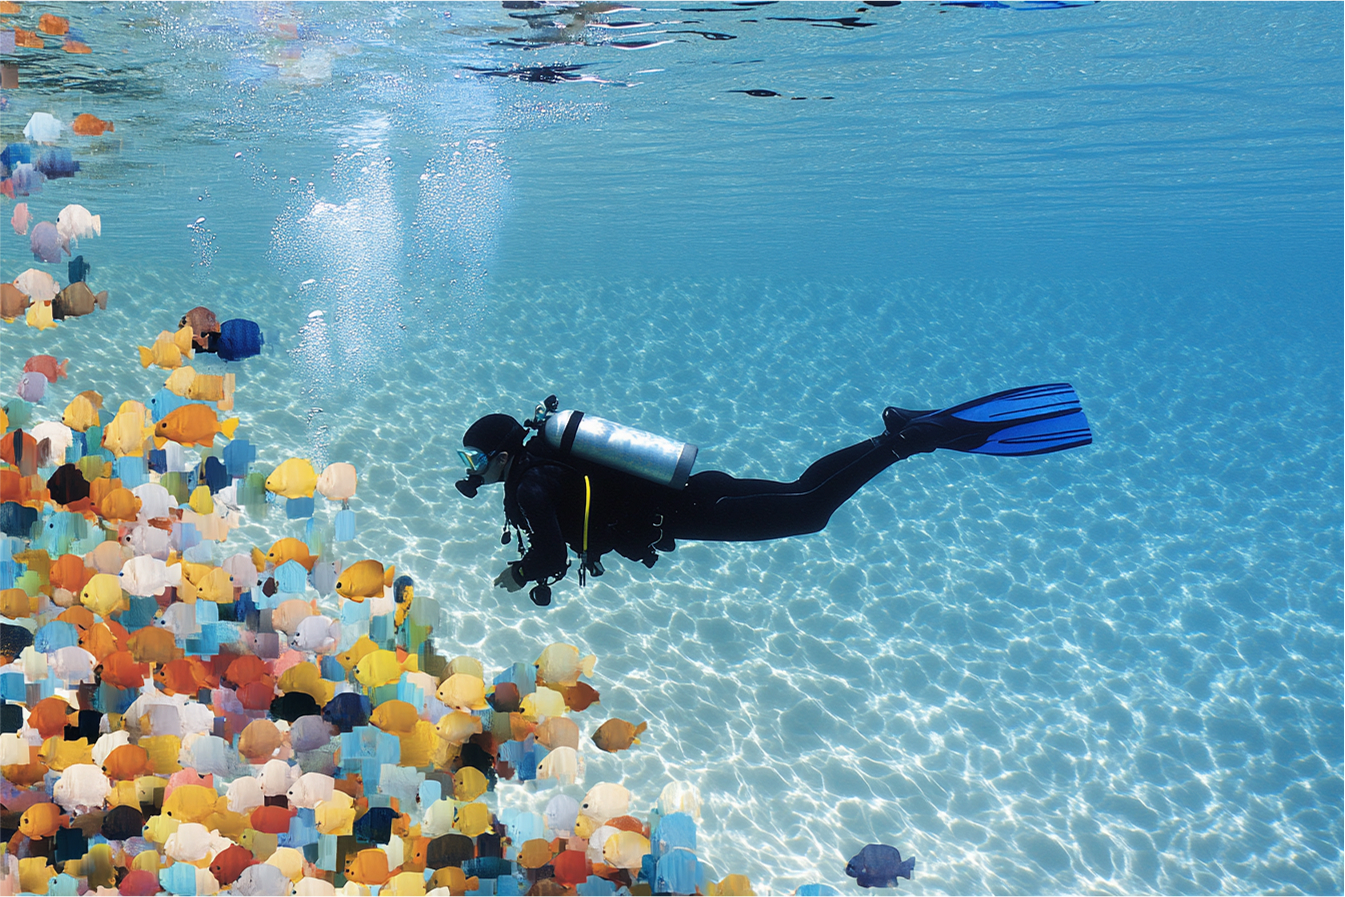
Диффузионная модель с учётом пикселей для реалистичного повышения разрешения изображений и персонализированной стилизации.