Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
Дорисовка фрагментов изображений с помощью SD и SDXL
Создание реалистичных фотографий людей по заданному образу с помощью Stacked ID Embedding
Превращайте обычные фотографии в волшебные работы в стиле Studio Ghibli
Редактирование изображений по изображению с помощью Step1X-Edit v2 от StepFun. Правки с рассуждениями в цикле «мышление — редактирование — рефлексия» и знаниями MLLM о мире для понимания абстрактных инструкций.
Цветокоррекция: настройка цветовой температуры, яркости, контраста, насыщенности и гаммы.
Универсальная модель генерации изображений, которая создаёт самые разные картинки по мультимодальным запросам. Подходит для редактирования изображений, персонализированной генерации, виртуальной примерки, генерации сцен с несколькими людьми и других задач.
Превращайте фотографии в забавные плюшевые игрушки, сохраняя узнаваемость исходных персонажей.
Мультимодальная модель на 7B параметров от Bytedance-Seed, умеющая генерировать и изображения, и текст.
Позволяет легко менять ракурс любого изображения.
Увеличивает разрешение изображения и очищает его от шумов и артефактов.
Запускает любую модель Stable Diffusion с настраиваемыми весами LoRA.
Диффузионная модель с учётом пикселей для реалистичного повышения разрешения изображений и персонализированной стилизации.
Генерация изображений с BitDance. Быстро создаёт фотореалистичные изображения высокого разрешения с помощью авторегрессионной LLM — эффективно и с высоким качеством.
Превращает обычные фотографии в эффектные профессиональные студийные портреты с идеальным светом и стилем high-end съёмки.

Любая поза, любой стиль, любая личность.
Создаёт качественные изображения за минимальное число шагов инференса. Оптимизирована для входных изображений размером 512x512.
Показывает, как вы или другие люди могли бы выглядеть в разном возрасте — от более молодого до старшего, с сохранением основных черт лица.
Запускайте SDXL со скоростью света.
Удаляет выделенные рамкой объекты вместе с их визуальными эффектами, а затем бесшовно восстанавливает сцену подходящим по контексту содержимым.
Превращает фотографии в яркие мультяшные картинки с чёткими контурами и насыщенными цветами.
Модель Dreamshaper.
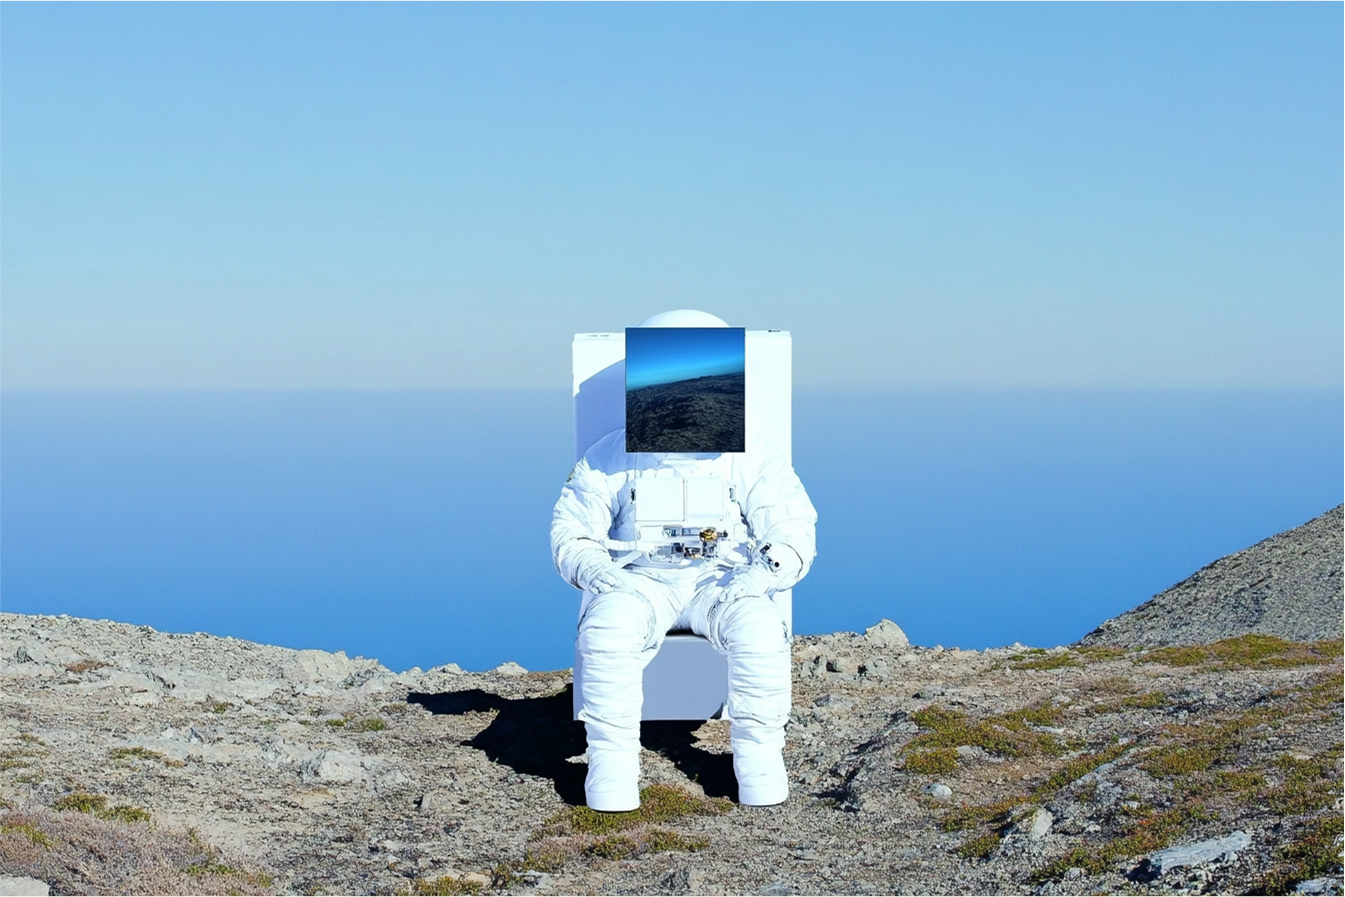
Finegrain Eraser удаляет любой объект, выделенный рамкой, вместе с тенями, отражениями и артефактами освещения и бесшовно восстанавливает сцену контекстно точным содержимым.
Превращает любого человека в его детскую версию, сохраняя исходную позу и выражение лица и добавляя детские черты.
Преобразует изображения в 3D-мультяшную графику: ИИ-модель применяет мультипликационную стилизацию, сохраняя композицию и детали оригинала.
Препроцессор для выделения контуров Holistically-Nested Edge Detection (HED).
ИИ-модель, которая преобразует входные изображения в новые по текстовым промптам, сочетая референсные изображения с вашими творческими указаниями.
OmniGen — универсальная модель генерации изображений, которая создаёт самые разные изображения по мультимодальным промптам. Подходит для редактирования изображений, персонализированной генерации, виртуальной примерки, генерации сцен с несколькими людьми и других задач.
Bagel — мультимодальная модель на 7B параметров от Bytedance-Seed, которая умеет генерировать и текст, и изображения.
Векторная генерация шрифтов с помощью VecGlypher. Создаёт собственные глифы по текстовому описанию или референсным изображениям и выдаёт чистые контуры SVG напрямую, без преобразования растра в вектор.
Превращайте фотографии в произведения искусства в духе известных стилей, например «Звёздной ночи» Ван Гога, или в любом другом выбранном стиле.
Генерация инфографики с помощью Sensenova U1.
Ovis-Image — модель на 7B параметров для генерации изображений по тексту, оптимизированная для быстрой и качественной отрисовки текста.
Превращает ваши фотографии в стиль wojak, сохраняя сходство с исходными персонажами
Изменение выражения лица на фотографиях с реалистичным результатом.
Естественное размещение товаров в руках человека для реалистичных маркетинговых визуалов.
DeepSeek Janus-Pro — новая модель для генерации изображений по тексту, которая объединяет мультимодальное понимание и генерацию в рамках авторегрессионного подхода