Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
Единая базовая модель SAM 3 для сегментации по подсказкам в изображениях и видео. Обнаруживает, сегментирует и отслеживает объекты по тексту или визуальным подсказкам: точкам, рамкам и маскам.
Модель Muse Image от Meta вносит точные правки, меняя только то, что вы просите, сохраняет связность от шага к шагу и собирает результат из нескольких референсных изображений.
Модель Muse Image от Meta точно следует инструкциям и отличается высокой визуальной достоверностью: мелкие детали, такие как текст, графики и QR-коды, передаются без искажений.
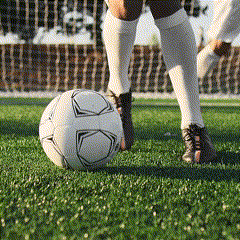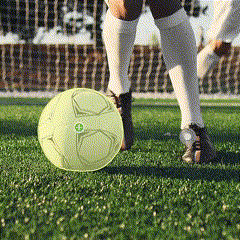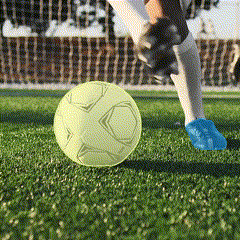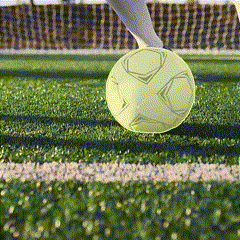
SAM 2 — модель для сегментации изображений и видео в реальном времени.
В SAM 3.1 появился Object Multiplex — подход с общей памятью для совместного отслеживания нескольких объектов, который работает быстрее при большом числе отслеживаемых объектов.
SAM 3 — универсальная базовая модель для сегментации изображений и видео по запросу. Обнаруживает, сегментирует и отслеживает объекты по текстовым и визуальным подсказкам: точкам, рамкам и маскам.
SAM 2 — модель для автоматической сегментации изображений. Может возвращать отдельные маски или одну маску для всего изображения.
В SAM 3.1 появился Object Multiplex — подход с общей памятью для совместного отслеживания нескольких объектов. Чем больше объектов в кадре, тем заметнее выигрыш в скорости.