Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
Muse Spark Open — модель с открытыми весами, оптимизированная для написания кода. Обучена специально для агентных сценариев программирования: чаще даёт верный результат с первой попытки, надёжно вызывает инструменты и глубоко понимает кодовую базу в репозиториях, с которыми работают разработчики...
Muse Wonder — передовая модель с рассуждениями от Meta для сложных личных и профессиональных агентных задач. Принимает текст, изображения, видео, аудио и PDF-документы, а возвращает текст, с...
Единая базовая модель SAM 3 для сегментации по подсказкам в изображениях и видео. Обнаруживает, сегментирует и отслеживает объекты по тексту или визуальным подсказкам: точкам, рамкам и маскам.
Модель Muse Image от Meta вносит точные правки, меняя только то, что вы просите, сохраняет связность от шага к шагу и собирает результат из нескольких референсных изображений.
Экономичный уровень Contributor мультимодальной модели с рассуждениями от Meta для экспериментов, обучения и ранних проектов с агентными и мультиагентными сценариями и программированием. Создана, чтобы отслеживать информацию...
Muse Spark 1.3 — мультимодальная модель с рассуждениями от Meta для долгих агентных и мультиагентных сценариев, а также для программирования. Она рассчитана на то, чтобы удерживать информацию в ходе продолжительных задач, прорабатывать...
Модель Muse Image от Meta точно следует инструкциям и отличается высокой визуальной достоверностью: мелкие детали, такие как текст, графики и QR-коды, передаются без искажений.
Модель с рассуждениями от Meta для разработчиков, которые хотят начать работу при ещё меньших затратах. Заметно дешевле, чем Muse Spark...
Плотная мультимодальная модель с открытыми весами от Meta Superintelligence Labs, полученная дистилляцией из Muse Spark и оптимизированная для автономных агентов на потребительском оборудовании. Подходит для долгосрочных...
Модель с рассуждениями от Meta для сложных агентных задач. Принимает текст, изображения, видео и PDF-документы, возвращает текст, контекстное окно — 1M токенов...
Мультимодальная модель с рассуждениями от Meta для агентных задач. Принимает текст, изображения, видео и PDF-документы, возвращает текст. Контекстное окно — 1M токенов.
Получение метаданных кодирования видео- и аудиофайлов через FFmpeg API.
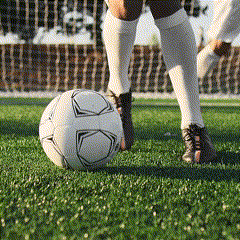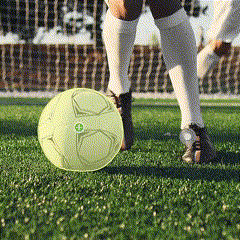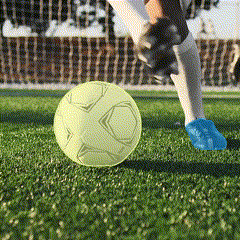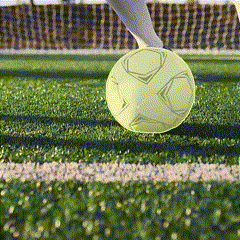
SAM 2 — модель для сегментации изображений и видео в реальном времени.
В SAM 3.1 появился Object Multiplex — подход с общей памятью для совместного отслеживания нескольких объектов, который работает быстрее при большом числе отслеживаемых объектов.
Универсальная базовая модель для сегментации изображений и видео по запросу. Обнаруживает, сегментирует и отслеживает объекты по текстовым или визуальным подсказкам: точкам, рамкам и маскам.
SAM 3D точно восстанавливает 3D-модели объектов по реальным изображениям, воспроизводя их геометрию и текстуру.
Мультимодальная предобученная модель на основе Llama 4 Scout, дообученная для классификации безопасности контента. Как и предыдущие версии, может использоваться для классификации контента как в LLM...
SAM 3 — универсальная базовая модель для сегментации изображений и видео по запросу. Обнаруживает, сегментирует и отслеживает объекты по текстовым и визуальным подсказкам: точкам, рамкам и маскам.
Llama 4 Maverick 17B Instruct (128E) — мультимодальная языковая модель Meta большой ёмкости на архитектуре MoE (mixture of experts): 128 экспертов и 17 миллиардов активных параметров на каждый прямой проход...
Языковая модель архитектуры MoE (mixture of experts) от Meta: 109B параметров, из них 17B активных. Поддерживает нативный мультимодальный ввод...
SAM 3 — универсальная базовая модель для сегментации изображений и видео по запросу. Обнаруживает, сегментирует и отслеживает объекты по текстовым и визуальным подсказкам: точкам, рамкам и маскам.
Многоязычная большая языковая модель (LLM) Meta Llama 3.3 — предобученная генеративная модель на 70B, дообученная на инструкциях (текст на входе, текст на выходе). Текстовая модель Llama 3.3, обученная следовать инструкциям...
Llama 3.2 1B — языковая модель на 1 млрд параметров для эффективного решения задач обработки естественного языка: суммаризации, диалога и многоязычного анализа текста. Небольшой размер позволяет ей работать...
Llama 3.2 3B — многоязычная большая языковая модель на 3 млрд параметров, оптимизированная для сложных задач обработки естественного языка: генерации диалогов, рассуждений и суммаризации. Построена на новейшей архитектуре трансформера, она...
SAM 3D точно восстанавливает 3D-форму и положение человеческого тела по одному изображению.
Новейшее семейство моделей Meta (Llama 3.1) вышло в разных размерах и вариантах. Эта версия на 70B, дообученная на инструкциях, оптимизирована для качественного диалога. Показала высокие...
Новейшее поколение моделей Meta (Llama 3.1) вышло в разных размерах и вариантах. Эта версия на 8B, обученная следовать инструкциям, быстрая и эффективная. Показала высокие результаты по сравнению с...
В SAM 3.1 появился Object Multiplex — подход с общей памятью для совместного отслеживания нескольких объектов, который работает быстрее при большом числе отслеживаемых объектов.
В SAM 3.1 появился Object Multiplex — подход с общей памятью для совместного отслеживания нескольких объектов, который работает быстрее при большом числе отслеживаемых объектов.
SAM 2 — модель для сегментации изображений и видео в реальном времени.
SAM 2 — модель для автоматической сегментации изображений. Может возвращать отдельные маски или одну маску для всего изображения.
В SAM 3.1 появился Object Multiplex — подход с общей памятью для совместного отслеживания нескольких объектов. Чем больше объектов в кадре, тем заметнее выигрыш в скорости.
Единая базовая модель SAM 3 для сегментации изображений и видео по подсказкам. Обнаруживает, сегментирует и отслеживает объекты по тексту или визуальным подсказкам: точкам, рамкам и маскам.
SAM 3D позволяет реконструировать сцены целиком, размещая объекты и людей в едином контексте.