Модели
Цены в рублях за 1 млн токенов или за единицу результата. Списание — по факту.
Генерация качественной музыки и звуковых эффектов с помощью Stable Audio 2.5 от StabilityAI.
Запуск SDXL на головокружительной скорости.
Stable Audio 3 Medium — латентная диффузионная модель на 1.4 миллиарда параметров. Генерирует качественную стереомузыку длительностью до 6 минут по текстовым запросам. Обучена на полностью лицензированных данных, поэтому безопасна для коммерческого использования.
Модель с открытым исходным кодом для генерации аудио по тексту.
Латентная диффузионная модель Stable Audio 3 Small SFX на 459 миллионов параметров генерирует качественные звуковые эффекты по текстовым промптам. Рассчитана на запуск прямо на устройстве: на смартфонах и обычных ноутбуках.

SDXL со скоростью света
Stable Audio 3 Small Music — латентная диффузионная модель на 459 миллионов параметров, которая по текстовому описанию создаёт полноценные стереокомпозиции длиной до 2 минут. Достаточно компактна для запуска прямо на устройстве.
Stable Audio 3 Medium audio-to-audio — латентная диффузионная модель на 1,4 млрд параметров. По входному аудиоклипу и текстовому промпту создаёт новые стереовариации длительностью до 6 минут.
Генерация качественной музыки и звуковых эффектов с помощью Stable Audio 2.5 от StabilityAI
Модель генерации изображений по тексту на архитектуре Multimodal Diffusion Transformer (MMDiT). Stable Diffusion 3.5 Large отличается улучшенным качеством изображений, типографикой, пониманием сложных промптов и экономным расходом ресурсов.
Запускайте SDXL со скоростью света

Stable Diffusion 3 Medium (генерация изображений по тексту) — мультимодальный диффузионный трансформер (MMDiT) с улучшенным качеством изображений, типографикой, пониманием запросов и эффективностью.
Stable Diffusion 3.5 Medium — модель генерации изображений по тексту на основе Multimodal Diffusion Transformer (MMDiT). Улучшены качество изображений, работа с типографикой, понимание сложных промптов и эффективность использования ресурсов.
Дорисовка фрагментов в аудио в Stable Audio 3 Medium: латентная диффузионная модель на 1,4 миллиарда параметров, которая по текстовым промптам заполняет или переделывает выбранные участки стереотрека. Поддерживает редактирование одного и нескольких фрагментов.
Латентная диффузионная модель Stable Audio 3 Small SFX audio-to-audio на 459 млн параметров. Преобразует входное аудио в новые варианты звуковых эффектов по текстовым промптам.
Stable Diffusion v1.5
Запускайте SDXL со скоростью света.
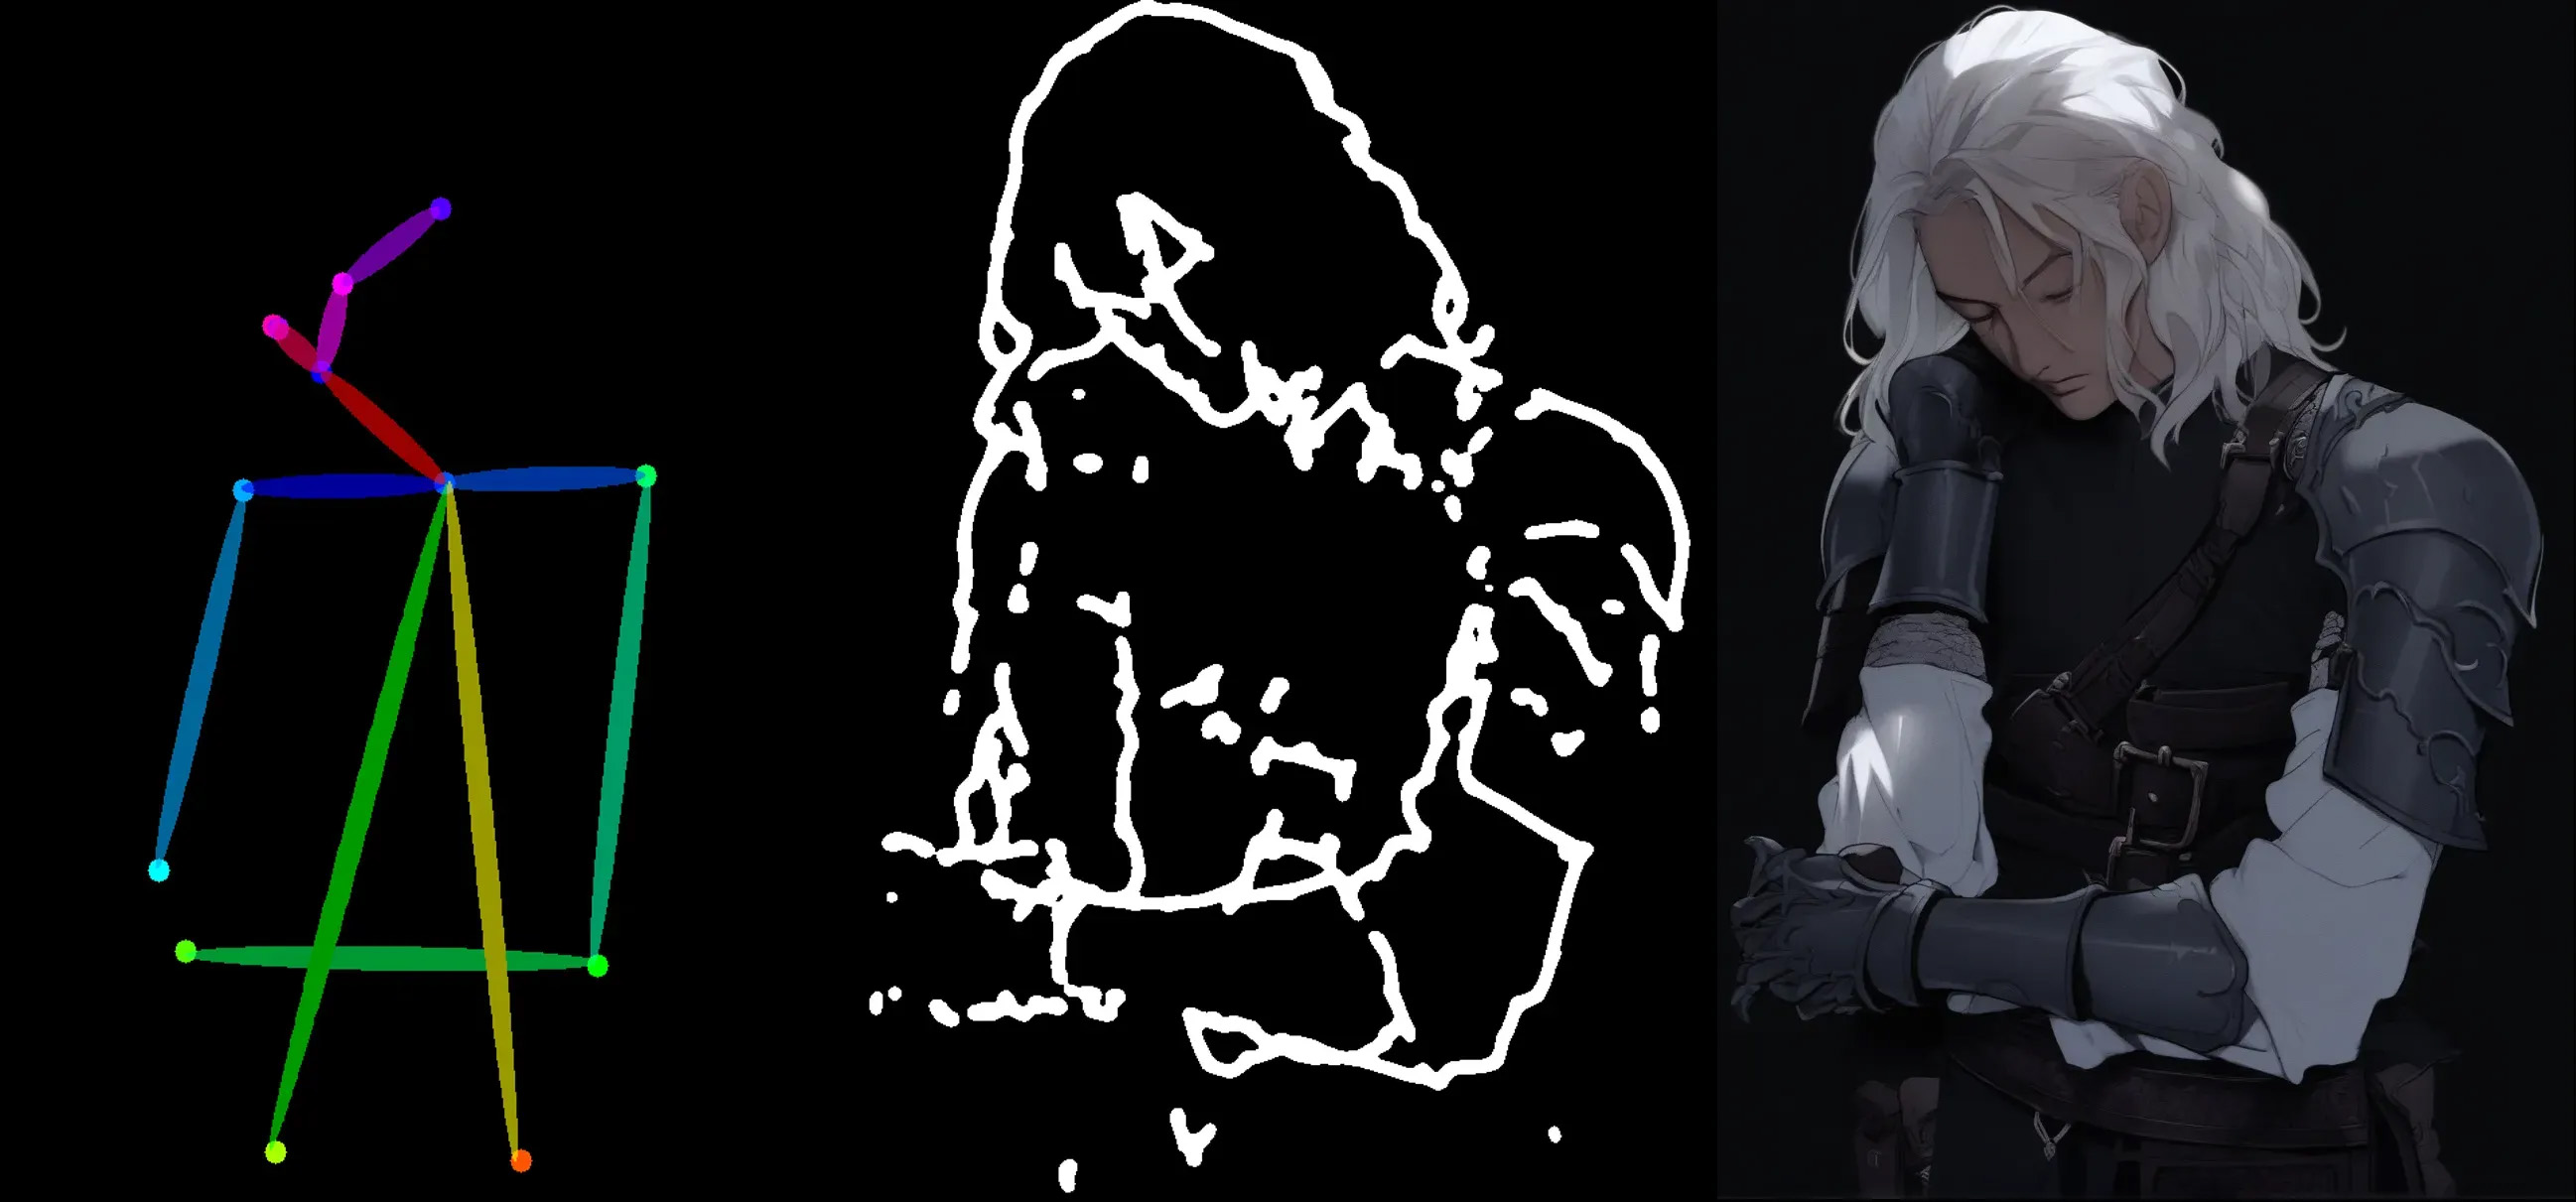
Эффективная модель SDXL для преобразования изображений с несколькими ControlNet.
SDXL со скоростью света.
Модель Stable Audio 3 Medium для расширения аудио (outpainting): латентная диффузионная модель на 1.4 миллиарда параметров, которая продолжает существующее стереозвучание за пределы исходной концовки путём каузального продолжения по текстовым промптам.

Создание коротких видеоклипов из ваших изображений с помощью SVD v1.1.
Stable Diffusion 3 Medium (Image to Image) — мультимодальный диффузионный трансформер (MMDiT), в котором улучшены качество изображений, типографика, понимание промптов и эффективность.
Эффективная модель для генерации изображений по тексту на базе SDXL с поддержкой нескольких ControlNet.
Базовый чекпойнт Stable Audio 3 Medium на 1,4 млрд параметров для генерации звука по тексту: создаёт стереомузыку длиной до 6 минут. Предназначен как неизменённая основа для собственного дообучения.
Stable Audio 3 Small Music audio-to-audio — латентная диффузионная модель на 459 миллионов параметров, которая превращает входную музыку в новые вариации длиной до 2 минут по текстовым запросам.
Генерация изображений с помощью ControlNet.
Stable Audio 3 Small Music для продолжения музыки — латентная диффузионная модель на 459 млн параметров, которая продлевает композиции за пределы исходного окончания с помощью каузального продолжения.
Stable Audio 3 Small SFX Base — базовый чекпоинт на 459 миллионов параметров, который генерирует звуковые эффекты по текстовым промптам. Предназначен как исходная модель для дообучения.
Эффективная модель дорисовки фрагментов на базе SDXL с несколькими ControlNet.
Создание качественной музыки и звуковых эффектов с помощью Stable Audio 2.5 от StabilityAI.
Stable Audio 3 Medium Base audio-to-audio — базовый чекпоинт на 1,4 млрд параметров, который по текстовому запросу преобразует входное аудио в новые стереовариации длительностью до 6 минут.
Stable Audio 3 Medium Base для дорисовки аудиофрагментов — базовый чекпоинт на 1,4 млрд параметров для редактирования или заполнения выбранных стереофрагментов по текстовым промптам.
Stable Audio 3 Small Music Base — базовый чекпоинт на 459 млн параметров, который генерирует по текстовым промптам полноценные музыкальные композиции длиной до 2 минут. Предназначен как исходная модель для дообучения.
Генерация изображений с помощью ControlNet.
Генерация изображений с помощью ControlNet.
Stable Audio 3 Small Music Base audio-to-audio — базовый чекпойнт на 459 миллионов параметров, который превращает входную музыку в новые вариации длиной до 2 минут по текстовым промптам.